这篇文章记录了我把家庭存储网络从 10GbE 升级到 40GbE,并进一步尝试 InfiniBand、IPoIB 和 RDMA 的过程。
它最初是一篇边搭建、边排错、边写的施工记录:前半段使用 TrueNAS SCALE,后来发现 SCALE 并不适合我的需求,于是把 ZFS 迁到了 NixOS;与此同时,交换机降噪、网卡固件、SR-IOV、ZFS 调优等内容也不断插入,最终让全文失去了主线。
2026 年重新整理后,本文按实际决策顺序重新编排:先说明最终架构,再介绍硬件和基础 40GbE 网络,之后才讨论 ZFS、虚拟化、InfiniBand 与 RDMA。文中的 ConnectX-3、TrueNAS SCALE 和 Proxmox VE 命令主要来自 2023 年的环境,今天使用时请先核对当前系统、内核、固件和官方文档。
如果目标只是让 NAS 与工作站之间达到 20~40Gbps,先把普通 40GbE 以太网跑稳定即可。InfiniBand、RDMA 和 SR-IOV 都不是必需条件,也不应该成为第一步。
1. 最终架构与升级目标
我把存储和计算分成了两台机器:
- NAS:负责 ZFS 存储,最终运行 NixOS;
- 计算节点:运行 Proxmox VE,虚拟机和容器的数据主要来自 NAS;
- 核心交换机:Mellanox SX6036;
- NAS 与 PVE:使用 HP 544+(ConnectX-3 Pro)接入 40/56Gbps 网络;
- 原有 10GbE 网络:通过 QSFP+ 转 SFP+ 与 SX6036 相连。
升级的目的并不是让单块机械硬盘跑到 40Gbps,而是让多个客户端、虚拟机、SSD 数据集和机械盘阵列共享足够大的网络带宽。实际性能仍然取决于存储池布局、文件大小、协议、CPU 单核能力和并发深度。
整个项目可以分成四层:
- 链路层:交换机、网卡、线缆、模块和 MTU;
- 存储层:ZFS vdev、ARC、special vdev、SLOG 和 L2ARC;
- 服务层:NFS、SMB、iSCSI 和 ZFS replication;
- 实验层:SR-IOV、IPoIB、NFS over RDMA 和 iSER。
建议严格按这个顺序搭建。先确认普通 TCP/IP 网络和存储池稳定,再逐层增加复杂度。
2. 硬件选择
2.1 核心设备
Mellanox SX6036
这是一台 36 口 QSFP 的 40/56Gbps 交换机,支持 Ethernet 与 InfiniBand。二手价格很有吸引力,但购买前需要确认:
- 是否已经获得 Ethernet 模式授权;
- 风道方向是否适合机柜;
- 电源和风扇是否齐全;
- 是否能接受功耗、噪声和老设备维护成本。
SX6036 很适合低成本实验 40GbE 和 FDR InfiniBand,但它已经是老设备,不应只看购买价格。
HP 544+
HP 544+ 本质上是 OEM 版 Mellanox ConnectX-3 Pro,支持 40/56Gbps、Ethernet/InfiniBand 和 SR-IOV。它价格便宜,但固件、OEM 限制和驱动版本会带来额外工作。
如果不想折腾,优先选择原厂 Mellanox 卡,或者选择仍处于较好软件支持周期的 ConnectX-4 及以后型号。
QSFP+ 线缆
短距离连接可以使用 DAC;我实际使用的是较细的 AOC,理线更方便。DAC 和 AOC 通常已经包含两端模块,不需要另购光模块。
如果要连接原来的 10GbE SFP+ 交换机,可以使用 Mellanox QSA(QSFP+ 转 SFP+)适配器。若使用 MPO 多模光纤,可根据交换机、网卡和速率选择兼容的 QSFP+ 模块。
不建议为了家用短距离网络购买 40G LR4 单模方案。除成本和兼容性外,短距离使用高功率单模模块还要关注接收光功率,必要时应按链路预算使用衰减器,而不是凭经验猜测。
2.2 可选设备
- Chelsio T580:FreeBSD 支持较好,普通 TCP/IP 延迟也不错,但功耗和发热非常高;
- Optane 或企业级 NVMe:适合作为低延迟 SLOG、special vdev 或独立 SSD 池,但三种用途不能混为一谈;
- SAS3 HBA 与背板:只有在确实使用 SAS SSD、SAS3 扩展器或需要相应带宽时才有意义;
- 机箱风道改造:高密度硬盘、HBA 和 40G 网卡都依赖持续风量,散热应当作为系统设计的一部分。
我的 NAS 机箱把原来的四个 80mm 风扇位改成了三个 120mm 风扇位,并使用追风者 T30。T30 需要把风扇中央开关拨到 Advanced 模式,才能达到最高转速。风扇架参考了这个 3D 打印设计。
二手服务器机箱、背板和电源板存在许多版本,也有兼容外壳。购买前应核对具体料号和尺寸,不能仅凭“846 机箱”判断配件一定兼容。
3. 先把 40GbE 以太网跑稳定
3.1 管理 SX6036
SX6036 可以通过管理口的 Web UI 管理,也可以使用 Console 线进入 CLI。首次设置、恢复配置和高级端口操作更适合使用 Console。
我遇到的几个要点:
- 用 QSA 连接 10GbE SFP+ 设备时,可能需要在 Web UI 中把对应端口速率固定为 10Gbps;
- 使用 QSFP+ 一分四线缆时,需要把端口配置为 breakout 模式,具体命令取决于当前系统版本;
- 某些光模块和端口组合存在限制,购买前应核对 SX6036 的硬件手册和模块兼容性;
- 每次更改后都要保存配置,否则重启后可能丢失。
不要在这一阶段同时引入 InfiniBand、RDMA、SR-IOV 和巨型帧。先完成最简单的 Ethernet 链路,并依次验证:
ip link
ethtool <interface>
ping <peer-ip>
iperf3 -s
iperf3 -c <peer-ip> -P 4
单流无法跑满并不一定代表链路有问题。40GbE 很容易受到 CPU、NUMA、PCIe 插槽带宽、网卡队列和协议实现影响,因此可以用多流 iperf3 区分“链路能力”和“单线程能力”。
3.2 MTU 9000
巨型帧可以降低高吞吐场景中的包处理开销,但不是 40GbE 的必要条件。只有当路径上的网卡、交换机、VLAN、网桥和虚拟接口全部支持相同 MTU 时才应启用。
先使用默认 MTU 1500 验证网络,再逐段改成 9000,并用禁止分片的 ping 检查端到端路径。混合 MTU 往往比保持 1500 更难排错。
4. SX6036 降噪与散热
SX6036 的风扇盒中有四个 40mm 风扇,电源中还有一个 40mm 风扇。我使用了五个 Noctua NF-A4x20 FLX 3-pin 风扇,只连接 12V 和 GND,让风扇保持全速。
原装风扇盒线序记录如下,但不同批次可能不同,动手前必须用万用表复核:
| 线色 | 定义 |
|---|---|
| 红 | +12V |
| 蓝 | RPM |
| 黄 | PWM |
| 黑 | GND |
Noctua PWM 版常见线序为:
| 线色 | 定义 |
|---|---|
| 蓝 | PWM |
| 绿 | RPM |
| 黄 | +12V |
| 黑 | GND |
若保留 PWM 控制,可在高级 CLI 中调整风扇:
enable
fae mlxi2c set_fan set_fan /FAN/FAN 1 65
fae mlxi2c set_fan set_fan /PS1/FAN 1 65
更换风扇后,交换机可能因读取不到预期转速而亮红灯,但不一定影响转发。不要因此忽略实际温度监控。
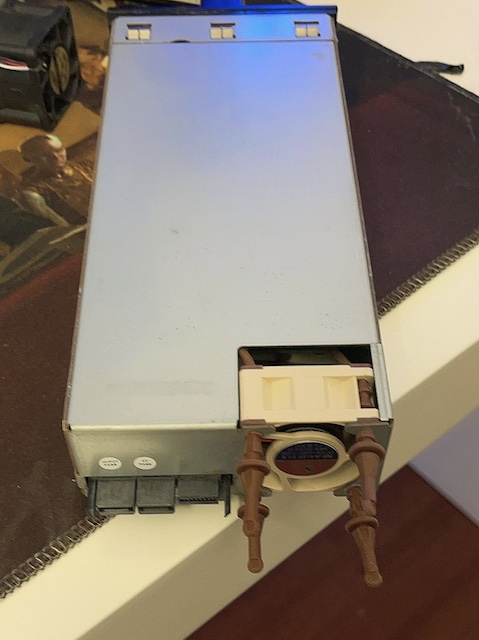
安全警告:电源内部存在致命高压。更换 PSU 风扇不属于普通维护操作,断电后电容仍可能带电。没有相关经验时请不要拆开电源,也不要把我的改造当作安全依据。
5. HP 544+ / ConnectX-3 Pro 的坑
5.1 固件与端口模式
HP 544+ 是 OEM 卡,不能简单地把它当成原厂 ConnectX-3 Pro 刷写。不同固件对 SR-IOV、UEFI 和主板兼容性的表现也不同。
在 Linux / Proxmox VE 中可先安装 Mellanox Firmware Tools,查看设备而不是直接写入:
apt update
apt install mstflint
lspci | grep -i Mellanox
mstflint -d 03:00.0 query
mstconfig -d 03:00.0 query
设备地址 03:00.0 只是示例,必须替换成自己的 PCI 地址。切换端口模式的示例:
mstconfig -d 03:00.0 set LINK_TYPE_P1=ETH修改固件配置或刷固件前,应先保存当前固件信息并确认卡的 PSID。刷错 OEM 固件可能让网卡失去功能。
5.2 SR-IOV
我的 NAS 不需要 SR-IOV,因此使用较新的 HPE 固件并关闭了它;PVE 节点需要把 VF 分配给虚拟机和容器,所以使用了在该主板上更稳定的旧固件。
固件层面的示例:
mstconfig -d 03:00.0 set SRIOV_EN=1 NUM_OF_VFS=8ConnectX-3 使用内核 mlx4_core 驱动时,还需要根据端口类型和 VF 数量配置模块参数。例如:
# /etc/modprobe.d/mlx4_core.conf
options mlx4_core port_type_array=1,2 num_vfs=3,4,0 probe_vf=1,4,0port_type_array=1,2表示端口 1 为 InfiniBand、端口 2 为 Ethernet;num_vfs和probe_vf的格式及限制与 mlx4 驱动版本有关;- 修改后需要更新 initramfs 并重启;
- 主板 BIOS、IOMMU、PCIe ARI、固件和驱动必须同时支持目标 VF 数量。
这部分最容易因版本差异出错。以上配置只能作为我的环境记录,不能直接复制。应先参考 NVIDIA 对应版本的 SR-IOV 文档,并从少量 VF 开始验证。
5.3 为 Ethernet VF 设置 MAC
创建 VF 后,我用脚本在宿主机启动时设置 MAC 和接口状态:
#!/usr/bin/env bash
set -e

ip link set dev enp2s0 mtu 9000
ip link set dev enp2s0 vf 0 mac ae:51:1a:2b:c0:00
ip link set dev enp2s0 vf 1 mac ae:51:1a:2b:c0:01
ip link set dev enp2s0 up
接口名、VF 数量、MAC 和 MTU 都必须按实际环境修改。若 PF 使用 MTU 1500,不要给 VF 单独配置 9000。
对应的 systemd 服务可以写成(保存为 /etc/systemd/system/mlx-sr-iov.service):
[Unit]
Description=Configure Mellanox SR-IOV VFs
After=network-pre.target
Before=network.target pveproxy.service

[Service]
Type=oneshot
ExecStart=/opt/sr-iov.sh
RemainAfterExit=yes

[Install]
WantedBy=multi-user.target
启用前先手动执行脚本确认没有报错:
chmod +x /opt/sr-iov.sh
systemctl daemon-reload
systemctl start mlx-sr-iov.service
systemctl enable mlx-sr-iov.service
如果 PVE 管理网络也依赖这些 VF,启动顺序尤其重要。虚拟机还应设置延迟启动,避免 VF 尚未就绪时启动失败。
5.4 VF 直通 Windows 与 LXC
ConnectX-3 VF 直通 Windows 曾经会在部分 PVE 内核上触发 Code 43。我当时为此维护过一个修改后的 PVE 内核,但现在不建议把旧内核补丁作为首选方案。更合理的顺序是:
- 先核对当前 PVE、QEMU、Windows 和驱动版本是否仍有这个问题;
- 优先使用发行版内核和受支持的网卡;
- 确认确实需要时,才维护自定义内核,并理解它对安全更新的影响。
LXC 可以直接使用宿主机中的 PF 或 VF。示例:
lxc.net.0.type: phys
lxc.net.0.flags: up
lxc.net.0.link: enp3s0v0
lxc.net.0.hwaddr: ae:54:1c:2b:c0:00
lxc.net.0.name: eth0
配置写入 /etc/pve/lxc/<CTID>.conf。本文只讨论网络直通示例;核显设备映射与 40GbE 主线无关。
6. Chelsio T580
T580 在 FreeBSD 下支持很好,在 Linux 下使用厂商驱动时则需要跟随内核重新编译。以旧版 PVE 环境为例,大致流程是安装当前内核 headers、修改驱动包的 Debian 构建选项,再指定内核目录编译。
这部分强烈依赖当前驱动包和内核版本,因此不再保留容易误导的固定命令。每次升级 PVE 内核前,都应确认厂商驱动能否重新构建。
macOS 官方 Chelsio 驱动只支持到较老系统。我曾保存过以下文件:
这些驱动不代表当前 macOS 仍然兼容。加载过期或修改过的内核扩展可能需要降低系统安全设置,使用前应自行评估风险。
T580 的发热非常大。被动散热片必须有服务器级持续风流,不能按普通桌面网卡使用;过热可能导致模块掉线甚至整卡失联。
7. ZFS 存储设计
我的机械盘主池由两组 10 盘 RAIDZ2 条带组成,另外保留热备盘。这里的重点不是复制盘数,而是理解性能边界:40GbE 只提供网络上限,不会自动消除机械盘的寻道、随机 I/O 和碎片化问题。
7.1 ashift
ashift 表示 vdev 的最小扇区大小,ashift=12 对应 4KiB,ashift=13 对应 8KiB。它在创建 vdev 时确定,之后不能原地修改。
zpool get ashift <pool>不要把 ashift 理解成文件的块大小;文件系统记录大小由 dataset 的 recordsize 或 zvol 的 volblocksize 决定。现代系统通常会自动选择,但创建池前仍应核对硬盘上报的逻辑/物理扇区与控制器行为。
7.2 special vdev
special vdev 不是缓存,而是池中永久存放 metadata、间接块,以及可选小数据块的顶层 vdev。它对机械盘池的目录遍历、快照、scrub 和大量小文件非常有效,但风险也最高:
- special vdev 中的数据没有另一份副本留在普通 vdev;
- special vdev 损坏可能导致整个池不可用;
- 它至少要拥有与普通数据 vdev 相当的冗余;
- 对含 RAIDZ 顶层 vdev 的池,加入后通常无法移除。
我使用 Optane 905P 与 Samsung 983 ZET 组成 mirror,作为机械盘主池的 special vdev。不同型号做镜像会受较慢、较小的一侧限制,但这是当时已有硬件下的折中。
小块阈值是 dataset 属性:
zfs set special_small_blocks=32K <pool/dataset>判断基于压缩后的物理块大小。把它设得接近 recordsize,可能让远多于预期的数据进入 special vdev,因此应从保守值开始,并持续观察容量。special class 接近保留阈值时,新的相应分配会回落到普通 class,但这不意味着可以放心把它写满。
7.3 SLOG
SLOG 是独立的 ZFS Intent Log 设备,不是通用写缓存。它只帮助同步写入;异步写入不会经过 SLOG。
适合 SLOG 的设备需要低延迟和断电保护。NFS、数据库和虚拟机存储可能受益,但普通大文件异步写入通常不会因为增加 SLOG 而变快。不要为了测速把 sync=disabled 当作永久优化,这会牺牲最近同步写入的持久性。
7.4 L2ARC
L2ARC 是二级读缓存,适合“工作集大于内存、且以重复随机读取为主”的负载。它不加速写入,而且会占用一部分 ARC 元数据。
在添加 L2ARC 前,先用 arc_summary / arcstat 观察 ARC 命中率和工作集。如果 ARC 仍有增长空间,增加内存通常比增加 L2ARC 更有效。L2ARC 设备不需要冗余,丢失后只会回源到主池读取。
L2ARC 的容量并不是固定为 ARC 的 4~5 倍。合适容量取决于块大小、内存开销、设备写入耐久度和实际工作集,应根据统计数据决定。
7.5 dedup
Dedup 不是普通家用池的默认优化。它需要维护 DDT,可能显著增加内存和随机 I/O 压力。dedup vdev 只是把 DDT 放到独立 allocation class,并不会消除 dedup 本身的成本。
是否开启应以真实数据的可去重比例和资源测算为依据。关闭属性只影响后续写入;已经去重的数据需要通过重新写入或 send/receive 才会变成非去重块。
7.6 独立 SSD 池与 ZFS replication
对于非常在意延迟、IOPS 和写碎片的工作集,我更倾向于建立独立 SSD 池,再定期复制到机械盘池,而不是把所有问题都交给 special vdev 或 L2ARC。
基本流程是创建快照后进行增量复制:
zfs snapshot SSD/works@backup-001
zfs send SSD/works@backup-001 | zfs receive Home/works-backup
生产环境更适合使用自动快照和 replication 工具,并定期验证恢复,而不是只确认任务显示“成功”。RAID0 SSD 池的性能很好,但源池本身没有冗余;复制周期决定最多会丢失多长时间的数据。
8. 文件服务与 40GbE
8.1 NFS
NFS 的上限与版本、线程、同步语义、文件大小和客户端实现都有关系。大文件顺序传输比较容易接近链路速度,小文件则更依赖元数据性能和延迟。
不要为了小文件机械地把服务端 block size、rsize 和 wsize 全部调小。先记录基线,再使用与实际负载相近的工具测试。MTU 9000 也应作为端到端验证后的可选优化,而不是默认答案。
macOS 的 Finder、NFS 客户端和 POSIX 工具可能表现不同,因此测试时要区分“网络吞吐”“协议吞吐”和“具体应用表现”。
8.2 SMB
SMB 性能会受到 Samba 版本、签名/加密、客户端实现、单核性能和并发数影响。SMB Multichannel 可以提高多链路或多队列场景的吞吐,但服务端和客户端都必须正确支持。
8.3 iSCSI 与 PVE
PVE 可以把远端块存储用于虚拟机。TrueNAS 与 PVE 的 ZFS over iSCSI 集成曾经需要第三方 provider,例如 freenas-proxmox。它本质上是让 PVE 远程管理 ZFS zvol,再通过 iSCSI 使用,并不等同于让 PVE 直接管理远端 ZFS 池。
插件、认证方式和 TrueNAS API 会随版本变化,部署前应先查看项目当前支持范围;也不要在配置或文档中硬编码 root 密码,或依赖过时的 API 说明。
9. InfiniBand 与 IPoIB
完成普通 40GbE 验证后,我把两张 HP 544+ 的一个端口切换为 InfiniBand,另一个端口保留 Ethernet:
mstconfig -d 03:00.0 set LINK_TYPE_P1=IB LINK_TYPE_P2=ETH在 SX6036 上需要切换到 VPI profile、设置各端口模式,并启用 Subnet Manager。一个 InfiniBand fabric 至少需要一个 SM;可以使用交换机内置 SM,也可以在网络中的 Linux 主机运行 OpenSM。
9.1 Proxmox VE 上配置 IPoIB
先确认驱动和接口存在:
modprobe ib_ipoib
modprobe ib_umad
ip link
旧版 ifupdown 环境示例:
auto ibp2s0
iface ibp2s0 inet static
        address 10.99.0.1/24
        mtu 2044
接口名和 MTU 取决于硬件、驱动与 IPoIB 模式。IB 网段应与 Ethernet 管理网段分开。
9.2 TrueNAS 的历史配置
我当时在 TrueNAS CORE 中通过 loader tunable 加载 mlx4ib,再用 post-init 脚本加载 ipoib;在 SCALE 中则手动加载 ib_ipoib 和 ib_umad,并修改网络配置文件。
这些做法容易被 TrueNAS 更新覆盖,而且当前版本的驱动和网络管理方式可能已经变化。因此只把它们作为历史记录,不再提供可直接复制的配置。若需要长期使用 IB,我更推荐选择允许正常管理内核模块和网络配置的通用 Linux 发行版。
IPoIB 让普通 IP 应用能够运行在 InfiniBand 上,但它仍然经过 IP 协议栈。低 ping 并不代表文件服务一定更快,也不等于已经使用 RDMA。
10. RDMA:最后再做的实验
RDMA 的价值是降低 CPU 参与和数据复制开销,但只有服务端、客户端、传输协议和应用全部支持时才生效。它不是打开网卡功能就会自动加速所有程序。
我主要尝试了两条路线:
10.1 NFS over RDMA
旧版 TrueNAS SCALE 使用内核 NFS server 时,可以加载 svcrdma,把 RDMA transport 绑定到端口 20049;PVE 客户端加载 xprtrdma 后,再用 proto=rdma 挂载。
历史命令示例:
# 服务端
modprobe svcrdma
echo rdma 20049 > /proc/fs/nfsd/portlist

# 客户端
modprobe xprtrdma
mount -t nfs 10.99.0.2:/mnt/SSD/works /mnt/test \
  -o vers=4.2,proto=rdma,port=20049,hard,_netdev
可以用 nfsstat -m 确认挂载实际使用的 transport。若当前内核或 NFS 实现不再提供这些模块,不能通过照抄旧命令解决。
10.2 iSER
iSER 是基于 RDMA 的 iSCSI transport。我当时只研究到 SCST / LIO 的实现方向,并没有完成一套可复现、可长期维护的 TrueNAS SCALE 部署,因此不再把它写成教程。
如果今天重新搭建,我会在通用 Linux 上选择发行版支持的 LIO 或 SCST,先完成普通 iSCSI 基线,再单独验证 iSER,而不会直接替换 TrueNAS 自带组件。
11. 我的测试环境
NAS
- CPU:AMD EPYC 7302P;
- 主板:Gigabyte MZ32-AR0;
- 内存:16GB DDR4 ECC RDIMM × 8;
- 主池:10 × 16TB RAIDZ2 + 10 × 12TB RAIDZ2,再由两个 vdev 组成存储池;
- special vdev:480GB Optane 905P + 480GB Samsung 983 ZET mirror;
- SSD 池:Kioxia CD6 3.84TB,定期 replication 到 HDD 池;
- 网卡:HP 544+,关闭 SR-IOV;
- HBA:LSI 9300-8i;
- 背板:Supermicro BPN-SAS3-846EL1;
- 系统:当时为 NixOS 22.05。
Proxmox VE 节点
- CPU:Intel Xeon E-2186G;
- 主板:Supermicro X11SCA-F;
- 内存:16GB DDR4 ECC UDIMM × 8;
- 网卡:HP 544+,启用 SR-IOV;
- 内核:当时使用自行修改的 Linux 6.0.15 PVE 内核。
这次升级我没有留下足够完整的测试方法和数据,因此不在这里补造结论。严谨的测试至少应同时记录:
iperf3单流与多流结果;- CPU 使用率、NUMA 和中断分布;
- fio 的块大小、队列深度、读写比例和同步选项;
- ZFS ARC 命中率、池占用率和碎片率;
- NFS/SMB/iSCSI 的具体版本与挂载参数。
12. 结论
这次升级最大的收获不是“家里终于有了 40Gbps”,而是厘清了网络、协议与存储之间的边界:
- 40GbE 解决的是链路带宽,不会自动解决机械盘随机 I/O;
- special vdev、SLOG 和 L2ARC 分别解决不同问题,不能统称为缓存;
- SR-IOV、InfiniBand 和 RDMA 都会显著增加维护成本;
- 对家用环境而言,稳定的 40GbE Ethernet、合理的 ZFS 布局和可验证的备份,通常比更复杂的协议更有价值;
- 调优必须从真实负载和基线数据出发,没有一组参数适合所有人。
如果重新做一次,我会先完成 40GbE Ethernet 与独立 SSD 池,再根据实际 CPU 占用和延迟决定是否引入 RDMA。这样更容易排错,也更容易长期维护。